从ResNeXt到“维哒网络” 一场关于神经网络架构演进的趣味探索
引言
在深度学习的发展历程中,卷积神经网络(CNN)的架构设计始终是研究的热点。从AlexNet到VGG,从GoogLeNet到ResNet,每一次架构的创新都推动着计算机视觉领域向前迈进。而在2017年,Facebook AI Research(FAIR)团队提出的ResNeXt网络,以其独特的“分组卷积+残差连接”设计,成为了ResNet家族中一颗璀璨的明珠。有趣的是,在中文技术社区里,ResNeXt曾被一些爱好者戏称为“维哒网络”(一种音译加意译的趣味叫法),这背后既体现了技术传播过程中的语言游戏,也反映了这一架构的独特魅力。本文将带您深入解析ResNeXt的核心思想,并一同探讨这个有趣的别名由来。
一、ResNeXt的诞生背景:ResNet的“加强版”
2015年,何恺明等人提出的ResNet(深度残差网络)通过引入“跳跃连接”(skip connection),成功训练了超过100层的神经网络,解决了梯度消失和网络退化问题。ResNet的基本单元是“瓶颈”结构:1×1卷积降维 → 3×3卷积 → 1×1卷积升维,然后与输入相加。
单纯增加深度会带来计算量的爆炸式增长。2016年,Inception系列网络通过在“宽度”上做文章,并行使用不同尺寸的卷积核,取得了很好的效果。是否存在一种既能增加容量、又不显著增加计算复杂度的设计范式?
2017年,ResNeXt给出了答案:在残差块中引入分组卷积(Group Convolution),并在每组内采用相同的拓扑结构。这种设计也被称为“基数(Cardinality)”的引入。
二、ResNeXt的核心思想:基数、分组与残差
2.1 从“深度”和“宽度”到“基数”
传统ResNet增加表达能力的方式主要是:增加深度(更多层)或增加宽度(更多通道)。ResNeXt提出第三个维度——基数(Cardinality),即分组卷积的组数。
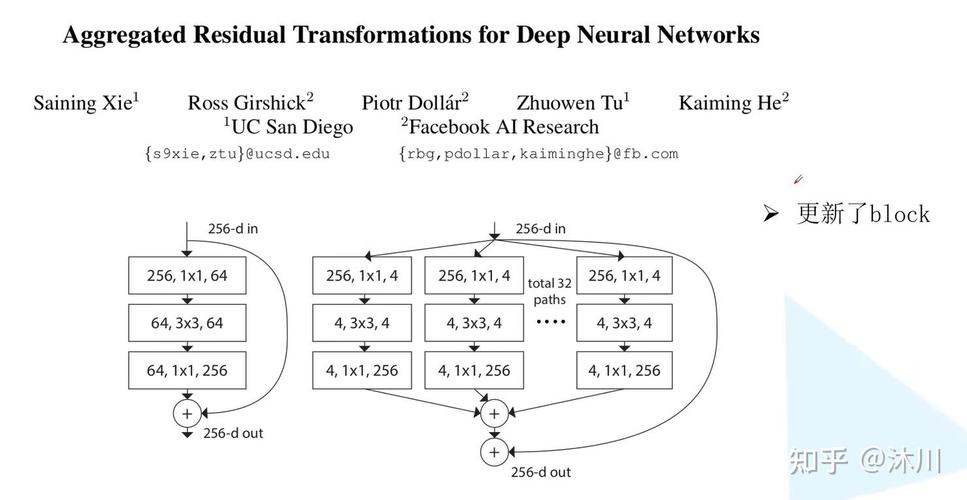
以一个标准的ResNeXt块为例:输入通道为256,首先通过1×1卷积降维到128。然后分成32组,每组独立进行3×3卷积(每组处理4个通道),最后再拼接起来,通过1×1卷积升维到256,与原始输入相加。
这种“分组卷积+残差连接”的结构,实际上等价于具有相同拓扑结构的多个分支并行,但实现上比Inception更简洁——所有分支结构相同,超参数只有“基数”和“每组宽度”。
2.2 与Inception、ResNet的对比
- ResNet:单路3×3卷积,靠深度取胜。
- Inception:多路不同尺寸卷积,手工设计感强,结构复杂。
- ResNeXt:多路相同结构,通过“基数”这一超参数控制容量,兼具Inception的“分裂-变换-合并”思想和ResNet的残差连接,实现了模块化与可扩展性。
2.3 核心公式
若输入为 \(x\),ResNeXt块可表示为:
\[ y = x + \sum{i=1}^{C} \mathcal{T}i(x) \]
其中 \(C\) 为基数,\(\mathcal{T}_i\) 为第 \(i\) 组内相同的变换(通常为1×1→3×3→1×1卷积)。当 \(C=1\) 时,退化为ResNet瓶颈块。
三、“维哒网络”:ResNeXt的中文趣味别名
在中文技术社区里,“ResNeXt”常被幽默地音译为“维哒网络”。这个别名的由来大致有以下几个版本:
- 音译派:ResNeXt读作/ˈrezneksɪt/,“Res”音似“维”,“NeXt”音似“哒克斯特”,简化为“维哒”。
- 意译派:“NeXt”有“下一代”之意,而“维”代表“维度”,暗示ResNeXt在维度(基数维度)上的创新,合起来“维哒”即有“维度打击”的戏谑含义。
- 社区梗:类似于把“PyTorch”叫作“劈叉”,把“TensorFlow”叫作“挑眉楼”,这是一种技术圈亚文化现象,方便记忆和传播。
无论哪种解释,“维哒网络”这个别名都让原本严肃的学术概念多了一层亲和力。在深入理解ResNeXt后,我们再喊它“维哒网络”,或许会心一笑:没错,这就是在网络结构中“降维打击”或“多维扩展”的那位选手。
四、ResNeXt的实验效果与影响
在原论文中,作者在ImageNet数据集上进行了大量实验。结果证明:
- 在相近计算量下,ResNeXt(如ResNeXt-101, 32×4d)相比ResNet-200、Inception-v4等,具有更高的准确率。
- 增加基数比增加深度或宽度更有效。例如,从1×64d(即普通ResNet)到32×4d,错误率显著下降,而计算量几乎不变。
ResNeXt的思想也影响了后续工作,如:
- Group Convolution被广泛应用于ShuffleNet、MobileNet等轻量级网络中。
- Transformer中的Multi-Head Attention可视为一种“基数”思想的拓展。
- 一些神经架构搜索(NAS)的结果也验证了分组残差结构的有效性。
五、代码示例:用PyTorch实现一个ResNeXt块
为直观理解,以下给出简化的PyTorch实现(基于 Bottleneck 结构,基数=32,每组宽度=4):
`python
import torch
import torch.nn as nn
class ResNeXtBlock(nn.Module):
def init(self, inchannels, outchannels, cardinality=32, basewidth=4):
super().init()
width = cardinality * basewidth # 中间层通道总数
self.conv1 = nn.Conv2d(inchannels, width, kernelsize=1, bias=False)
self.bn1 = nn.BatchNorm2d(width)
self.conv2 = nn.Conv2d(width, width, kernelsize=3, padding=1,
groups=cardinality, bias=False) # 分组卷积
self.bn2 = nn.BatchNorm2d(width)
self.conv3 = nn.Conv2d(width, outchannels, kernelsize=1, bias=False)
self.bn3 = nn.BatchNorm2d(outchannels)
self.shortcut = nn.Sequential()
if inchannels != outchannels:
self.shortcut = nn.Sequential(
nn.Conv2d(inchannels, outchannels, kernelsize=1, bias=False),
nn.BatchNorm2d(outchannels)
)
def forward(self, x):
identity = self.shortcut(x)
out = torch.relu(self.bn1(self.conv1(x)))
out = torch.relu(self.bn2(self.conv2(out)))
out = self.bn3(self.conv3(out))
out += identity
return torch.relu(out)`
这段代码中,groups=cardinality实现了分组卷积,与残差相加实现了跳跃连接。
六、与展望
ResNeXt(“维哒网络”)以其简洁而强大的设计哲学——“分裂-变换-合并,再叠加残差”,在深度学习架构演进中留下了深刻的印记。它不仅提供了一种高效扩大网络容量的方法,更启发了后续大量关于分组、基数、多分支结构的研究。
当我们以幽默的方式称它为“维哒网络”时,不妨记住它的真谛:在维度(caxi)上做文章,用分组的方式实现“多路径并行”,从而让网络更强、更快、更优雅。随着自动化架构搜索和新硬件的发展,类似ResNeXt这样的模块化思想将继续焕发生命力。
“维哒网络,用基数说话。” —— 送给所有拥抱深度学习的实践者。
如若转载,请注明出处:http://www.wetech-buy.com/product/17.html
更新时间:2026-10-07 14:22:45